Tilstandsdatahistorikk og ekspertvurderinger kan kombineres i en bayesiansk modell. I den kombinerte SME-modellen i forrige kapittal bidro begge datatypene direkte til likelihooden og vektingen ble bestemt av usikkerheten/spredningen i dataen. I en Bayesiansk model brukes gjerne ekspertvurderingene som priorinformasjon for parametrene , hvor . TK-data og ekspertvurderinger kombineres ved hjelp av Bayes’ teorem
Det endelige resultatet er en posteriorfordeling for parametrene basert på begge typer data. Disse brukes for å regne ut endelig gammafordeling med usikkerhet.
Likning (1) over kan løses analytisk for noen fordelinger. For andre fordelinger, og når vi har med ekte data å gjøre, er ikke dette mulig. Derfor anvender vi Monte Carlo simuleringer som beskrevet i Welte, T. (2008) Estimation of Sojourn Time Distribution Parameters Based on Expert Opinion and Condition Monitoring Data.
Source
# nødvendige moduler og funksjoner for sme og plotting
from scipy.stats import gamma
import numpy as np
from scipy.optimize import minimize
import matplotlib.pyplot as plt
from scipy.stats import uniform
%config InlineBackend.figure_format = 'retina'
import matplotlib as mpl
mpl.rcParams.update({
    "figure.facecolor": "none",
    "axes.facecolor": "none",
    "savefig.facecolor": "none",})


def loglikelihood_exp(par, q10, q50, sigma):
    mu, theta = par

    if mu <= 0 or theta <= 0:
        return -np.inf

    shape = mu / theta

    q10_model = gamma.ppf(0.10, a=shape, scale=theta)
    q50_model = gamma.ppf(0.50, a=shape, scale=theta)

    q10 = np.asarray(q10)
    q50 = np.asarray(q50)

    return -0.5 * np.sum(
        ((q10 - q10_model) / sigma) ** 2 +
        ((q50 - q50_model) / sigma) ** 2
    )

def loglikelihood_exp_vec(mu, theta, q10, q50, sigma):

    mu = np.asarray(mu)
    theta = np.asarray(theta)

    shape = mu / theta

    q10_model = gamma.ppf(0.10, a=shape, scale=theta)
    q50_model = gamma.ppf(0.50, a=shape, scale=theta)

    q10 = np.asarray(q10)[None, :]
    q50 = np.asarray(q50)[None, :]

    ll = -0.5 * np.sum(
        ((q10 - q10_model[:, None]) / sigma) ** 2 +
        ((q50 - q50_model[:, None]) / sigma) ** 2,
        axis=1
    )

    ll[(mu <= 0) | (theta <= 0)] = -np.inf

    return ll

def loglikelihood_data(par, xmin, xmax):
    mu, theta = par

    if mu <= 0 or theta <= 0:
        return -np.inf

    shape = mu/theta

    diff = (
        gamma.cdf(xmax, a=shape, scale=theta)
        - gamma.cdf(xmin, a=shape, scale=theta)
    )

    diff = np.clip(diff, 1e-300, None)

    return np.sum(np.log(diff))

def loglikelihood_data_vec(mu, theta, xmin, xmax):

    mu = np.asarray(mu)
    theta = np.asarray(theta)

    shape = mu / theta

    diff = (
        gamma.cdf(np.asarray(xmax)[None, :],
                  a=shape[:, None],
                  scale=theta[:, None])
        -
        gamma.cdf(np.asarray(xmin)[None, :],
                  a=shape[:, None],
                  scale=theta[:, None])
    )

    diff = np.clip(diff, 1e-300, None)

    ll = np.sum(np.log(diff), axis=1)

    ll[(mu <= 0) | (theta <= 0)] = -np.inf

    return ll

def negloglikelihood_all(par, q10, q50, sigma, xmin, xmax):
    return -loglikelihood_exp(par, q10, q50, sigma)-loglikelihood_data(par, xmin, xmax)

def plot_results(theta_prior, mu_prior, mle_result, mle_result2=None, data = ['','']):

    fig, ax = plt.subplots(figsize=(4,3))
    plt.scatter(theta_prior,
                mu_prior,
                s=20,
                alpha=0.6,
                color="tab:red",
                edgecolor="k",
                linewidth=0.3,
                label="Posterior samples")
    ax.scatter(
        mle_result.x[1],
        mle_result.x[0],
        s=200,
        color="white",
        edgecolors="k",
        marker="*",
        label=f"SME {data[0]}",
        zorder=10
    )

    if mle_result2 is not None:
        ax.scatter(
            mle_result2.x[1],
            mle_result2.x[0],
            s=200,
            color="green",
            edgecolors="k",
            marker="*",
            label=f"SME {data[1]}",
            zorder=10
        )
    plt.xlim([0,30]);plt.ylim([20,50]);
    plt.ylabel('mu');plt.xlabel('theta');plt.legend();
    ax.set_title(f"Posterior distribution and SME ({data[0]} {data[1]})")
    ax.grid(alpha=0.3)
    plt.tight_layout()

    fig, ax = plt.subplots(2, 1, figsize=(4, 5))
    ax[0].hist(
        mu_prior,
        bins=30,
        density=True,
        color="tab:blue",
        alpha=0.7,
        edgecolor="k"
    )
    ax[0].set_xlabel(r"mu");ax[0].set_ylabel("f(t)")
    ax[0].set_xlim([20,50])
    ax[0].set_title(f"P(mu|{data[0]} {data[1]})")
    ax[0].grid(alpha=0.3)

    ax[1].hist(
        theta_prior,
        bins=30,
        density=True,
        color="tab:orange",
        alpha=0.7,
        edgecolor="k"
    )
    ax[1].set_xlabel(r"theta");ax[1].set_ylabel("f(t)")
    ax[1].set_xlim([0,30])
    ax[1].set_title(f"P(theta|{data[0]} {data[1]})")
    ax[1].grid(alpha=0.3)
    plt.tight_layout()

def plot_gamma_95unc(mu_post,theta_post,res,res2=None, res3=None,data=['','','']):
    x = np.linspace(0, 120, 500)
    shape_post = mu_post / theta_post
    # PDF for every posterior sample
    pdfs = np.array([
        gamma.pdf(x, a=a, scale=th)
        for a, th in zip(shape_post, theta_post)
    ])

    pdfs = pdfs[np.all(np.isfinite(pdfs), axis=1)]


    # posterior summaries
    pdf_mean = np.mean(pdfs, axis=0)
    pdf_low = np.percentile(pdfs, 2.5, axis=0)
    pdf_high = np.percentile(pdfs, 97.5, axis=0)

    # SME based on posterior data fit
    mu_mle = res.x[0]
    theta_mle = res.x[1]

    pdf_mle = gamma.pdf(
        x,
        a=mu_mle/theta_mle,
        scale=theta_mle
    )

    if res2 is not None:
        mu_mle2 = res2.x[0]
        theta_mle2 = res2.x[1]

        pdf_mle2 = gamma.pdf(
            x,
            a=mu_mle2/theta_mle2,
            scale=theta_mle2
        )

    if res3 is not None:
        mu_mle3 = res3.x[0]
        theta_mle3 = res3.x[1]

        pdf_mle3 = gamma.pdf(
            x,
            a=mu_mle3/theta_mle3,
            scale=theta_mle3
        )

    fig, ax = plt.subplots(figsize=(6,4))
    ax.fill_between(
        x,
        pdf_low,
        pdf_high,
        color="tab:green",
        alpha=0.25,
        label="95% credible interval"
    )

    ax.plot(
        x,
        pdf_mean,
        color="tab:green",
        lw=3,
        label="Posterior mean density"
    )

    ax.plot(
        x,
        pdf_mle,
        "--",
        color="black",
        lw=2,
        label=f"SME density {data[0]}"
    )


    if res2 is not None:
        ax.plot(
                x,
                pdf_mle2,
                "--",
                color="gray",
                lw=2,
                label=f"SME density {data[1]}"
            )

    if res3 is not None:
        ax.plot(
                x,
                pdf_mle3,
                "--",
                color="blue",
                lw=2,
                label=f"SME density {data[2]}"
            )

    ax.set_xlabel("Tid (år)");ax.set_ylabel("f(t)")
    ax.grid(alpha=0.3);ax.legend()
    ax.set_ylim([0,0.035])
    plt.tight_layout()
Monte Carlo sampling av P(|eksperter) og P(|eksperter)
Vi bruker ekspertvurderingene til å regne ut en priorfordeling for parametrene og . Dette gjøres ved å trekke sampler fra uniforme fordelinger av og (antar ingen informasjon tilgjengelig annet enn ekspertvurdering) og se på akseptkriteriet
hvor trekkes fra en uniform fordeling . Vi bruker samme funksjoner for likelihood som i SME. Se Welte. T (2008) for mer detaljer. Kode for sampling er vist under:
def sample(
        loglikelihood,
        llmax,
        prior_mu=None,
        prior_theta=None,
        S=1000,
        batch=1000):

    rng = np.random.default_rng()
    keep_mu = np.empty(S);keep_theta = np.empty(S)
    counter = 0
    while counter < S:
        if hasattr(prior_mu, "rvs"):
            mu_draw = prior_mu.rvs(size=batch, random_state=rng)
            theta_draw = prior_theta.rvs(size=batch, random_state=rng)
        else:
            idx = rng.integers(0, len(prior_mu), batch)
            mu_draw = prior_mu[idx]
            theta_draw = prior_theta[idx]

        ll = loglikelihood(mu_draw, theta_draw)

        R = np.minimum(ll - llmax, 0)

        accept = np.log(rng.random(batch)) <= R

        idx = np.flatnonzero(accept)
        take = min(len(idx), S-counter)
        keep_mu[counter:counter+take] = mu_draw[idx[:take]]
        keep_theta[counter:counter+take] = theta_draw[idx[:take]]

        counter += take
    return keep_mu, keep_theta
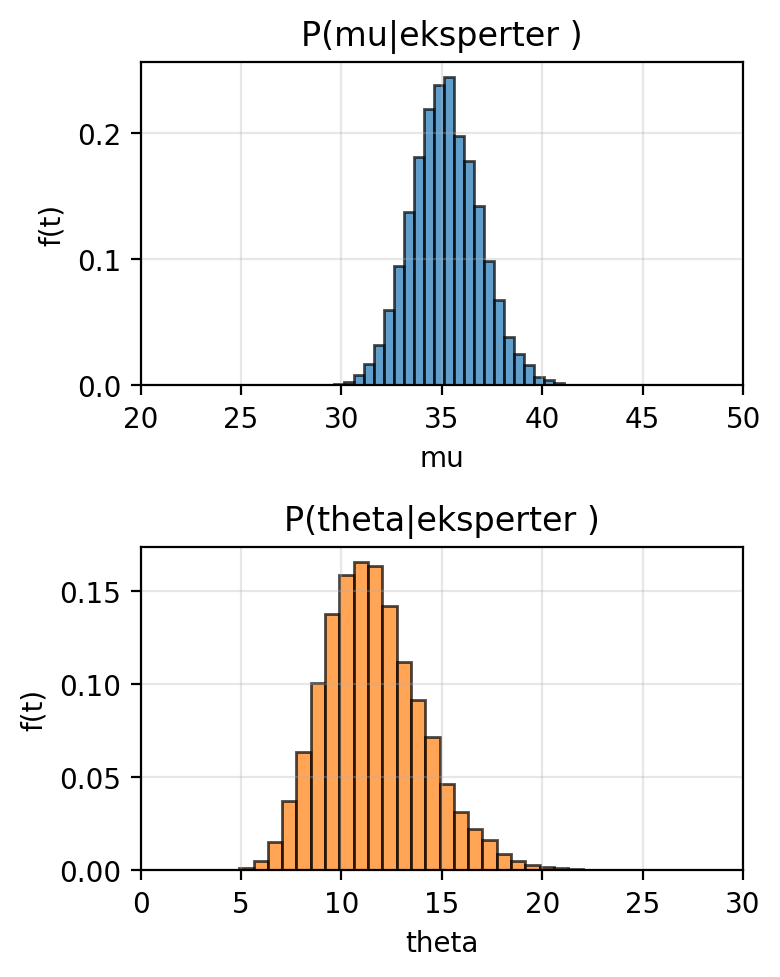
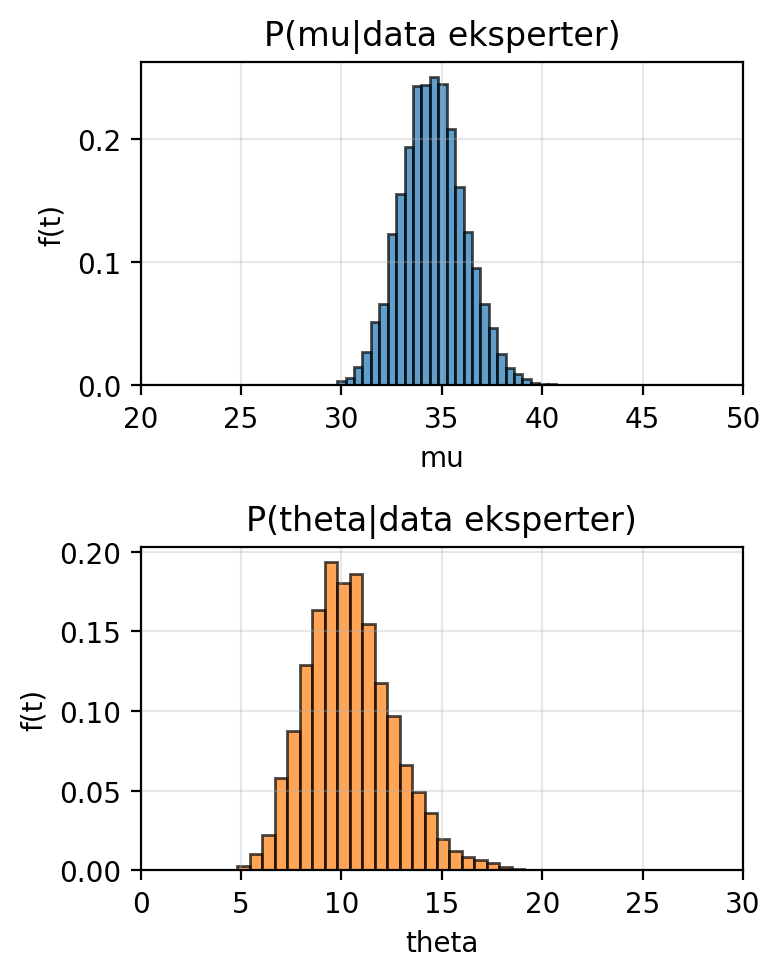
Nå definerer vi ekspertvurderingene og regner ut for akseptkritetiet i likning (2). De resulterende plottene viser aksepterte sampler og tilhørende fordelinger for og gitt ekspertvurderingene.
q10 = [10,15,15]
q50 = [30,35,29]
sigma = [2,2,2]

S = 20_000 # samples

res_exp = minimize(
    lambda par, q10, q50, sigma:
        -loglikelihood_exp(par, q10, q50, sigma),
    x0=[20, 5],
    args=(q10, q50, sigma),
    bounds=[(1e-6, None), (1e-6, None)]
)

llmax_exp = -res_exp.fun

mu_prior, theta_prior = sample(
    loglikelihood=lambda mu, th:
        loglikelihood_exp_vec(mu, th, q10, q50, sigma),
    llmax=llmax_exp,
    prior_mu=uniform(1, 59),
    prior_theta=uniform(1, 59),
    S=S,
    batch=S
)

plot_results(theta_prior, mu_prior, res_exp, data = ['eksperter',''])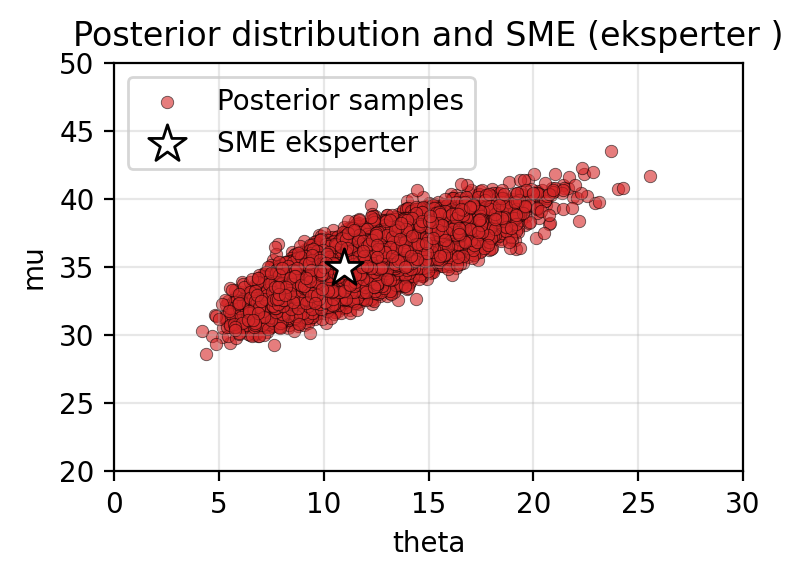
Full bayesiansk modell
Over regnet vi ut en prior for parametrene. Disse brukes så til å finne posterior fordelingene gitt informasjon om TK-data i tillegg. Under er TK-data definert og prosessen repeteres, men nå brukes prior som vist i plottene over istedefor uniforme fordelinger. Det vil si, samplene som trekkes nå kommer kun fra prior gitt av ekspertvurderingene.
minT = [15, 25, 35, 50, 10, 45, 30, 30, 40, 25]
maxT = [20, 30, 40, 55, 15, 50, 35, 35, 45, 30]

res_data = minimize(
    lambda par, xmin, xmax:
        -loglikelihood_data(par, xmin, xmax),
    x0=[20, 5],
    args=(minT, maxT),
    bounds=[(1e-6, None), (1e-6, None)]
)

llmax_data = -res_data.fun

# regn ut pi(data|eksperter)
mu_post, theta_post = sample(
    loglikelihood=lambda mu, th:
        loglikelihood_data_vec(mu, th, minT, maxT),
    llmax=llmax_data,
    prior_mu=mu_prior,
    prior_theta=theta_prior,
    S=S,
    batch=S
)
plot_results(theta_post, mu_post, res_data, res_exp, data = ['data','eksperter'])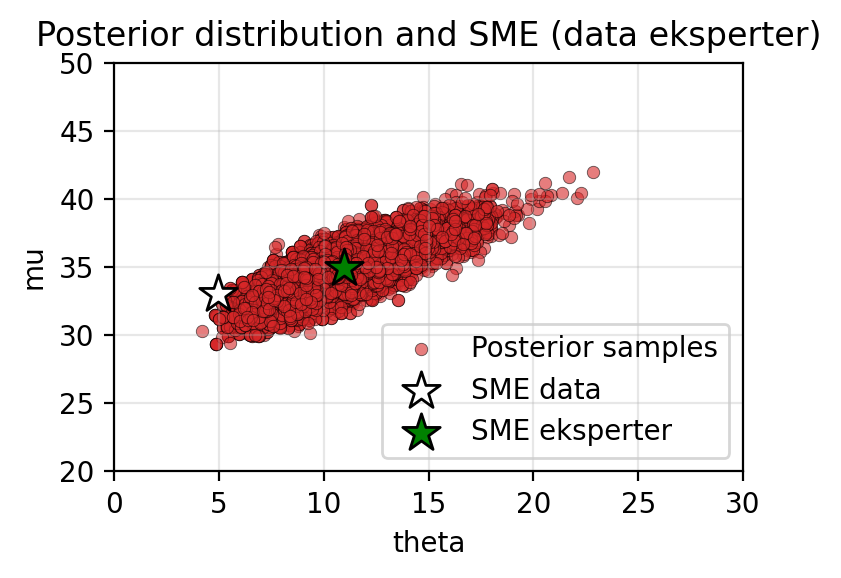
Resultat
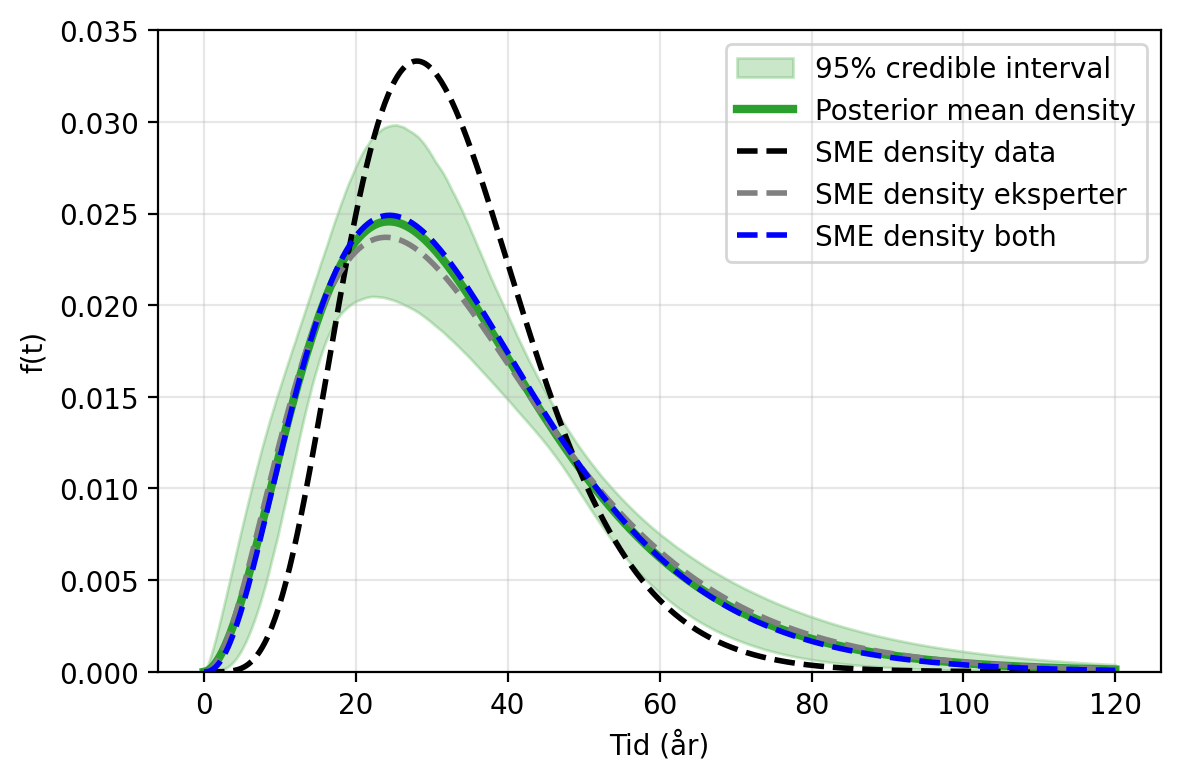
Til slutt plotter vi resulterende gammafordeling med usikkerhet. Her representerer posterior mean density den endelige fordeling med 95% konfidensintervall.
Source
res_mle = minimize(
    negloglikelihood_all,
    x0=[20, 5],
    args=(q10, q50, sigma, minT, maxT),
    bounds=[(1e-6, None), (1e-6, None)]
)

plot_gamma_95unc(mu_post,theta_post,res_data,res_exp,res_mle,data=['data','eksperter','both'])