Denne notebooken viser hvordan man kan analysere levetidsdata for komponenter når man ikke har observert svikt på alle komponentene i datasettet. Den går gjennom hvilke data som trengs, viser to verktøy for å estimere pålitelighet (Kaplan-Meier og en tilpasset sannsynlighetsfordeling), sammenligner resultatene, og regner ut betinget sviktsannsynlighet basert på disse estimatene.
Viktig: Resultatene er statistiske estimater basert på et begrenset antall komponenter. Usikkerheten til estimatene må derfor også vurderes.
Hva slags data trenger vi?
For å bruke verktøyene i denne notebooken må vi ha informasjon om mange like eller lignende komponenter (f.eks. alle generatorer av samme type). For hver komponent trenger vi:
Alder – hvor mange år komponenten har vært i drift, fram til enten svikt, utskifting, eller “i dag” hvis den fortsatt er i drift uten svikt (eventuelt: tid fra den ble satt tilbake til “god som ny” etter vedlikehold/utskifting)
Utfall – om perioden endte med svikt, eller om den er sensurert
Hva betyr sensurering?
Anta at vi følger en komponent i 15 år uten at den svikter, og deretter slutter vi å observere den (den byttes ut, eller vi avslutter datainnsamlingen). Vi vet da at komponenten overlevde minst 15 år, men vi vet ikke hvor lenge den ville ha vart om vi hadde fortsatt å observere den. Dette kalles en sensurert tid. Hvis vi bare hadde sett bort fra sensurerte komponenter, ville vi systematisk undervurdert levetiden, siden det generellt er de mest pålitelige komponentene som ender opp sensurert.
Vi markerer sensurerte tider med indikatoren , og svikttider med .
Regel for nullstilling av alder:
Svikt: man registrerer en svikttid, telling nullstilles for komponenten etter reparasjon/utskifting ()
Utskifting før svikt: man registrerer en sensurert tid, telling nullstilles ()
Minimalt vedlikehold (komponenten forblir i samme tilstand som før): telling fortsetter uendret
Vedlikehold til “god som ny”: man registrerer en sensurert tid, telling nullstilles ()
Eksempel på datasett
| Komponent-ID | Alder | Havarert |
|---|---|---|
| 1 | 38 | 0 |
| 2 | 71 | 1 |
| 3 | 12 | 0 |
| ... | ... | ... |
Source
# importer nødvendige python-moduler
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from reliability.Fitters import Fit_Gamma_2P
from reliability.Nonparametric import KaplanMeier
from scipy.stats import gamma
# les og formatter datasettet
df = pd.read_excel("ttt_data.xlsx")
failures = df.loc[df["Havarert"] == 1, "Alder"].values
right_censored = df.loc[df["Havarert"] == 0,"Alder"].valuesKaplan-Meier for sensurerte datasett
Teori
Kaplan-Meier estimat er en MLE for pålitelighetsfunksjonen . gir sannsynligheten for at en enhet overlever til tid t uten svikt. Sviktsannsynligheten er definert som
R(t) estimeres ved
hvor vi har parametrene:
: Estimert sannsynlighet for overlevelse til tidspunkt .
: Tidspunktet vi ønsker å estimere overlevelsesfunksjonen for.
: Tidspunktet for den -te observerte hendelsen.
: Antall hendelser ved tidspunkt . Denne er 0 når .
: Antall enheter som er i risikosettet rett før tidspunkt . Altså alle enheter som fortsatt opererer like før den -te hendelsen.
: Produktoperator som multipliserer bidragene fra alle hendelsestidspunkter fram til og med tidspunkt .
Sensurerte observasjoner bidrar i estimatet gjennom frem til tidspunktet de sensureres, men teller ikke som hendelser.
Praktisk bruk av Kaplan-Meier
Kaplan-Meier-estimatet krever ingen antakelse om hvilken fordeling levetiden følger og er derfor et godt utgangspunkt for å få et første, “modellfritt” bilde av hvordan komponentene oppfører seg. Man bruker det typisk til å:
Få et raskt overblikk over overlevelseskurven for en komponentgruppe
Sjekke om en senere tilpasset fordeling (f.eks. gammafordeling) faktisk beskriver dataene godt
Begrensning: Kaplan-Meier gir kun et estimat for de tidspunktene der data faktisk finnes. For å si noe om sviktsannsynlighet fram i tid, utover det vi har observert, trenger vi en tilpasset fordeling.
Om usikkerhet: Med få komponenter og få observerte svikt blir estimatet usikkert, særlig i halene av kurven (svært lav eller svært høy alder). Kaplan-Meier-estimatet bør derfor suppleres med konfidensintervall før man trekker konklusjoner.
km = KaplanMeier(
    failures=failures,
    right_censored=right_censored,
    label='Svikt + høyresensurerte observasjoner',
    print_results=False #Fjern denne linjen hvis du vil ha resultatet direkte i terminalen
)

# Label på KI
ax = plt.gca()
for coll in ax.collections:
    if coll.get_label().startswith('_'):
        coll.set_label('95% KI')

plt.xlabel("Alder (år)")
plt.ylabel(r"Pålitelighetsestimat $\hat{R}(t)$")
plt.title("Kaplan-Meier estimat")
plt.grid()
plt.legend()
plt.show()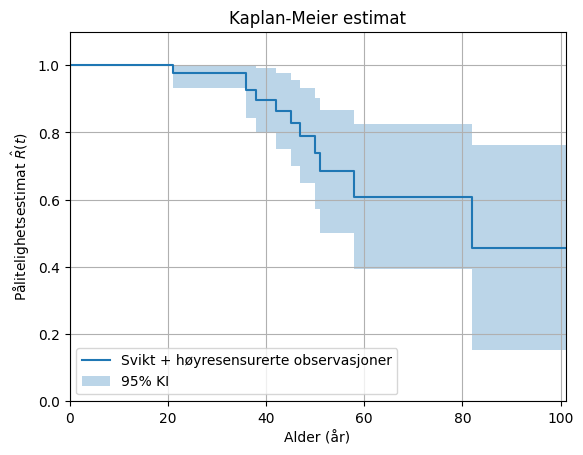
Konfidensintervall
Konfidensintervallet til Kaplan-Meier-estimatet regnes ut med Greenwoods formel for varians:
hvor , og har samme betydning som i formelen for Kaplan-Meier.
Variansen vil være stor når det er få enheter i risikosettet og er liten. Variansen vil også påvirkes av hvor mange enheter som svikter samtidig, og vil være større når er større.
95%-konfidensintervall regnes ut som
Tilpasning av gammafordeling
Kaplan-Meier gir oss et bilde av hvordan pålitelighet har utviklet seg historisk, men sier ingenting om hvordan den vil utvikle seg framover i tid. For å kunne predikere framtidig sviktsannsynlighet, tilpasser vi isteden en matematisk fordeling til dataene.
Hvorfor gammafordeling?
Gammafordelingen er fleksibel og mye brukt for levetidsdata fordi den kan beskrive både komponenter der sviktraten er tilnærmet konstant og komponenter som degraderer (aldres) over tid. Fordelingen er styrt av to parametre:
Formparameter (, “shape”): bestemmer formen på fordelingen.
: avtakende sviktintensitet (typisk tidlige feil / innkjøringsfeil)
: konstant sviktintensitet (tilfeldige feil, ingen aldring)
: økende sviktintensitet (aldring/slitasje)
Skalaparameter (, “scale”): bestemmer hvor “utstrakt” i tid fordelingen er (høyere → lengre forventet levetid)
MERK: Reliability-biblioteket bruker uvanlig parametrisering....
Hvordan estimeres parametrene?
Parametrene estimeres ved maximum likelihood-estimering (MLE): reliability-biblioteket hensyntar de sensurerte observasjonene.
Om usikkerhet: Jo færre observerte svikt vi har, jo mer usikre blir parameterestimatene.
Fit_Gamma_2P gir også ut konfidensintervall for parametrene (se fit.results), og disse
bør sjekkes før man stoler på prediksjonene – spesielt langt fram i tid, utenfor det
tidsrommet vi faktisk har data for.
Praktisk bruk
Den tilpassede gammafordelingen brukes videre i notebooken til å beregne betinget sviktsannsynlighet – altså sannsynligheten for at en komponent svikter i en gitt framtidig periode, basert på hvor gammel den er i dag. Dette er hovedformålet med å tilpasse en fordeling i utgangspunktet, og noe Kaplan-Meier-estimatet alene ikke kan gi oss.
# Tilpasser gammafordelingen
fit = Fit_Gamma_2P(
    failures=failures,
    right_censored=right_censored,
    show_probability_plot=False,
    print_results=False
)

dist = fit.distribution

# Forventningsverdi
mean_life = fit.alpha * fit.beta # samme som theta*alpha

# 10-persentil (10 % har feilet)
p10 = dist.quantile(0.10)

# Plot overlevelsesfunksjon
dist.SF(label="Tilpasset gammafordeling")

# Marker nøkkeltall i plottet
plt.axvline(mean_life, color="green", linestyle="--",
            label=f"Forventningsverdi = {mean_life:.1f} år")

plt.axvline(p10, color="red", linestyle=":",
            label=f"10-persentil = {p10:.1f} år")

plt.xlabel("Alder (år)")
plt.ylabel(r"Pålitelighetsestimat $\hat{R}(t)$")

tittel = (
    "Tilpasset gammafordeling\n"
    rf"$\alpha={fit.beta:.4f},\ \theta={fit.alpha:.4f}$"           #korrigert alpha/beta/theta
    f"\nE[T] = {mean_life:.1f} år, 10-persentil = {p10:.1f} år"
)

plt.title(tittel)
plt.grid(True)
plt.legend()
plt.show()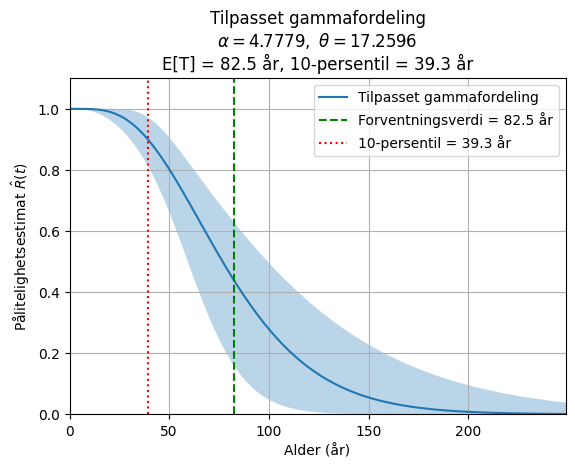
Sammenligning av Kaplan-Meier og tilpasset gammafordeling
Vi har nå to uavhengige estimater for pålitelighetsfunksjonen : det ikke-parametriske Kaplan-Meier-estimatet, og den tilpassede gammafordelingen. Ved å plotte disse sammen kan vi vurdere om gammafordelingen faktisk passer godt til dataene.
Hvordan tolke plottet:
Ligger kurvene tett på hverandre gjennom hele tidsrommet vi har data for, er det et godt tegn på at gammafordelingen beskriver dataene rimelig godt.
Systematiske avvik (f.eks. at gammafordelingen ligger konsekvent over eller under Kaplan-Meier) kan tyde på at fordelingen ikke fanger opp den faktiske degraderingsprofilen.
Legg merke til at Kaplan-Meier-kurven kun er definert i det tidsrommet vi har data. Gammafordelingen kan derimot ekstrapoleres utover dette.
fig, ax = plt.subplots(figsize=(7, 6))

km = KaplanMeier(
    failures=failures,
    right_censored=right_censored,
    label='Kaplan-Meier (empirisk)',
    print_results=False
)

# Label på KI
ax = plt.gca()
for coll in ax.collections:
    if coll.get_label().startswith('_'):
        coll.set_label('95% KI')

dist = fit.distribution
dist.SF(label="Tilpasset gammafordeling")


plt.xlabel("Alder (år)")
plt.ylabel(r"Pålitelighetsestimat $\hat{R}(t)$")
plt.title("Sammenligning: Kaplan-Meier vs. tilpasset gammafordeling")
plt.grid()
plt.legend()
plt.show()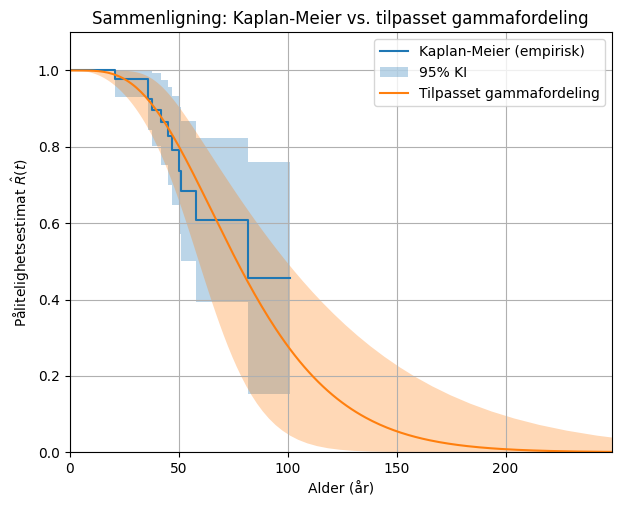
Betinget sviktsannsynlighet
Et av bruksområdene for den estimerte pålitelighetsfunksjonen er å beregne framtidig sviktsannsynlighet for en komponent basert på dens alder. Den betingede sannsynligheten for at komponenten svikter i alderen mellom og , gitt at den har overlevd fram til alder , er gitt ved:
der:
er komponentens levealder (stokastisk variabel)
er overlevelsesfunksjonen (sannsynligheten for at komponenten ikke har sviktet innen alder )
er komponentens nåværende alder
er den framtidige alderen vi ønsker å vite sviktsannsynligheten fram til
# Betinget sannsynlighet for svikt i intervallet [a_alder, b_alder], gitt at komponenten har overlevd fram til a_alder

def betinget_sannsynlighet(alpha, theta, a_alder, b_alder):
    """
    Sannsynlighet for at komponenten svikter i alderen mellom a_alder og b_alder,
    gitt at den fortsatt lever ved a_alder.
    alpha = formparameter, theta = skalaparameter i den tilpassede gammafordelingen.
    """
    R_a = gamma.sf(a_alder, a=alpha, scale=theta)  # overlevelsessannsynlighet ved a_alder
    R_b = gamma.sf(b_alder, a=alpha, scale=theta)  # overlevelsessannsynlighet ved b_alder
    return 1 - R_b / R_a

# Velg alderen komponenten har i dag, og alderen vi vil vite sviktsannsynligheten fram til
a_alder = 50   # komponenten har overlevd til denne alderen
b_alder = 70   # hva er sannsynligheten for svikt innen denne alderen?

theta_hat = fit.alpha # korriger parametrisering
alpha_hat = fit.beta

# Usikkerheten i parametrene fra MLE-tilpasningen, brukt som grunnlag for alle tre KI-metoder
var_theta = fit.alpha_SE**2
var_alpha = fit.beta_SE**2
cov_alpha_theta = fit.Cov_alpha_beta
cov_matrix = np.array([
    [var_alpha, cov_alpha_theta],
    [cov_alpha_theta, var_theta]
])

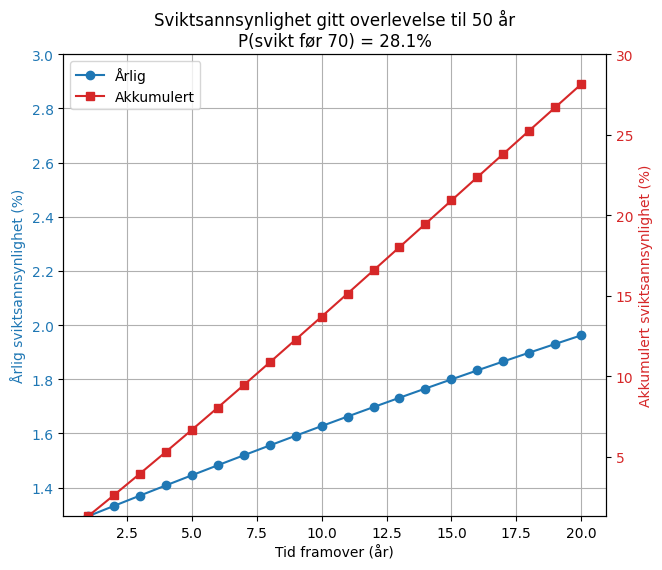
p_hat = betinget_sannsynlighet(alpha_hat,theta_hat, a_alder, b_alder)
print(f"Punktestimat for betinget sviktsannsynlighet de neste {b_alder-a_alder} år,\ngitt at komponenten har overlevd i {a_alder} år allerede: {p_hat:.1%}")

s_alder=a_alder
a=[]
r=[]
for i in range(20):
    a.append(i+1)
    cp=betinget_sannsynlighet(alpha_hat,theta_hat, s_alder+i,s_alder+i+1)
    r.append(cp*100)


# regn ut akkumulert sviktsannsnynlighet
acc = []
for i in range(20):
    #annual_p = np.array(r[0:i+1]) / 100
    #acc_i = 1 - np.prod(1 - annual_p) # gir samme svar
    acc_i = betinget_sannsynlighet(alpha_hat,theta_hat, s_alder,s_alder+i+1)
    acc.append(acc_i*100)

fig, ax1 = plt.subplots(figsize=(7, 6))

# Venstre akse: årlig sviktsannsynlighet
ax1.plot(a, r, '-o', color='tab:blue', label='Årlig')
ax1.set_xlabel("Tid framover (år)")
ax1.set_ylabel("Årlig sviktsannsynlighet (%)", color='tab:blue')
ax1.tick_params(axis='y', labelcolor='tab:blue')
ax1.grid(True)
ax1.set_ylim([acc[0],3])

# Høyre akse: akkumulert sviktsannsynlighet
ax2 = ax1.twinx()
ax2.plot(a, acc, '-s', color='tab:red', label='Akkumulert')
ax2.set_ylabel("Akkumulert sviktsannsynlighet (%)", color='tab:red')
ax2.tick_params(axis='y', labelcolor='tab:red')
ax2.set_ylim([acc[0],30])

# Felles legend
lines = ax1.get_lines() + ax2.get_lines()
labels = [line.get_label() for line in lines]
ax1.legend(lines, labels, loc='upper left')

plt.title(
    f"Sviktsannsynlighet gitt overlevelse til {a_alder} år\n"
    f"P(svikt før {b_alder}) = {p_hat:.1%}"
)

plt.show()

# Kontroller at årlig sviktsannsynlighet gir samme totale betingede sannsynlighet
annual_p = np.array(r) / 100
p_50_70 = 1 - np.prod(1 - annual_p)
#print(f"{np.round(p_50_70*100,1)}%")
#ok
Punktestimat for betinget sviktsannsynlighet de neste 20 år,
gitt at komponenten har overlevd i 50 år allerede: 28.1%
Konfidensintervall for punktestimat
Metode 1: Lognormalfordelt Monte Carlo-simulering
For å finne et konfidensintervall rundt den betingede sviktsannsynligheten, må vi ta hensyn til at parametrene i den tilpassede gammafordelingen ( og ) i seg selv er usikre estimater — de er basert på et begrenset antall observerte svikt, og ville sett litt annerledes ut om vi hadde hatt et annet utvalg av like mange komponenter.
Vi bruker en Monte Carlo-simulering for å få fram denne usikkerheten:
Vi trekker mange tilfeldige kombinasjoner av rundt de tilpassede verdiene, basert på hvor usikre parameterestimatene er (og hvordan de eventuelt samvarierer).
For hver kombinasjon regner vi ut den betingede sviktsannsynligheten på nytt.
Spredningen i de tusenvis av resultatene gir oss et 95 %-konfidensintervall: vi tar de 2,5 % laveste og 2,5 % høyeste verdiene som intervallgrenser.
Vi trekker fra en lognormalfordeling (dvs. at og trekkes fra en normalfordeling) i stedet for en vanlig normalfordeling. Dette sikrer at alle trukne verdier automatisk blir positive, slik en skala- og formparameter i en gammafordeling må være. En vanlig normalfordelt simulering kan derimot trekke negative verdier for og når usikkerheten er stor, noe som ikke gir noen fysisk mening og gjør resultatet skjevt eller misvisende.
Fallgruve: Metoden antar at usikkerheten i parametrene er tilnærmet lognormalfordelt. Dette er ofte en rimelig antakelse, men kan bli mindre treffende ved svært få observerte svikt, der den faktiske usikkerheten kan ha en annen form enn det vi antar her.
# Metode 1: Lognormal Monte Carlo


N = 10_000  # antall simuleringer

mean_log = np.array([np.log(theta_hat), np.log(alpha_hat)])
cov_log = np.array([
    [var_theta / theta_hat**2,              cov_alpha_theta / (theta_hat * alpha_hat)],
    [cov_alpha_theta / (theta_hat * alpha_hat), var_alpha / alpha_hat**2]
])

samples_log = np.random.multivariate_normal(mean=mean_log, cov=cov_log, size=N)

p_lognormal = []
for log_theta, log_alpha in samples_log:
    alpha_i, theta_i = np.exp(log_alpha), np.exp(log_theta)
    p = betinget_sannsynlighet(alpha_i, theta_i, a_alder, b_alder)
    if np.isfinite(p):
        p_lognormal.append(p)

p_lognormal = np.array(p_lognormal)
lower_lognormal, upper_lognormal = np.percentile(p_lognormal, [2.5, 97.5])

print(f"Lognormal MC        95 % KI = ({lower_lognormal:.1%}, {upper_lognormal:.1%})  "
      f"[{len(p_lognormal)}/{N} gyldige trekk]")
Lognormal MC 95 % KI = (16.5%, 53.4%) [10000/10000 gyldige trekk]
Metode 2: Delta-metoden
Delta-metoden er en analytisk (ikke-simulert) tilnærming som bruker en lineær tilnærming rundt punktestimatet til å beregne usikkerheten direkte. Vi bruker en logit-transformasjon for å sikre at intervallgrensene alltid holder seg mellom 0 % og 100 %.
Fallgruve: Delta-metoden bygger på en lineær tilnærming, og blir mindre pålitelig jo større usikkerheten i parametrene er. Med mange observerte svikt (stort datagrunnlag) fungerer den vanligvis godt, men ved få svikt bør man stole mer på Monte Carlo-metoden over, eller bootstrap-metoden under.
# Metode 2: Delta-metoden (med logit-transformasjon)


def logit(p):
    return np.log(p / (1 - p))

def inv_logit(x):
    return 1 / (1 + np.exp(-x))

def gradient_logit(alpha, theta, a_alder, b_alder, h=1e-5):
    d_alpha = (logit(betinget_sannsynlighet(alpha + h, theta, a_alder, b_alder))
               - logit(betinget_sannsynlighet(alpha - h, theta, a_alder, b_alder))) / (2 * h)
    d_theta = (logit(betinget_sannsynlighet(alpha, theta + h, a_alder, b_alder))
              - logit(betinget_sannsynlighet(alpha, theta - h, a_alder, b_alder))) / (2 * h)
    return np.array([d_alpha, d_theta])

grad_logit = gradient_logit(alpha_hat,theta_hat, a_alder, b_alder)
se_logit_p = np.sqrt(grad_logit.T @ cov_matrix @ grad_logit)
logit_p_hat = logit(p_hat)

lower_delta = inv_logit(logit_p_hat - 1.96 * se_logit_p)
upper_delta = inv_logit(logit_p_hat + 1.96 * se_logit_p)

print(f"Delta-metoden       95 % KI = ({lower_delta:.1%}, {upper_delta:.1%})")

print("\n--- Oppsummering ---")
print(f"Punktestimat: {p_hat:.1%}")
print(f"Lognormal MC: ({lower_lognormal:.1%}, {upper_lognormal:.1%})")
print(f"Delta-metode: ({lower_delta:.1%}, {upper_delta:.1%})")
Delta-metoden 95 % KI = (14.5%, 47.4%)
--- Oppsummering ---
Punktestimat: 28.1%
Lognormal MC: (16.5%, 53.4%)
Delta-metode: (14.5%, 47.4%)
Hvordan tolke resultatene: Er intervallene fra de to metodene rimelig like, styrker det tilliten til estimatet. Er de svært forskjellige – særlig hvis delta-metoden skiller seg mye fra Monte Carlo-metoden – er det et tegn på at usikkerheten i den underliggende gammatilpasningen er stor (typisk ved få observerte svikt), og resultatet bør tolkes med ekstra varsomhet.
Konfidensintervall med parametrisk bootstrap
Begge metodene over bygger på én felles antakelse: at usikkerheten i de tilpassede parametrene (alpha, theta) er tilnærmet normalfordelt. Dette holder vanligvis godt når man har mange observerte svikt, men kan være en dårlig tilnærming når man har få.
Bootstrap er en mer robust, men beregningstung, metode som ikke bygger på denne antakelsen. fremgangsmåten er som følger:
Bruk den tilpassede modellen til å simulere et helt nytt datasett som er like stort som det ekte og med samme sensureringsmønster.
Tilpass en ny gammafordeling til dette simulerte datasettet, akkurat som vi gjorde med de ekte dataene.
Regn ut betinget sviktsannsynlighet for denne nye tilpasningen.
Gjenta dette tusenvis av ganger.
Ved å finne 2,5-persentilen og 97,5-persentilen i disse resultatene finner vi et konfidensintervall som reflekterer den faktiske usikkerheten i dataene.
Fallgruve: Bootstrap er beregningstungt (kan ta flere minutter å kjøre) og forutsetter fortsatt at gammafordelingen i utgangspunktet er en rimelig modell for dataene – bootstrap retter ikke opp i en modell som i utgangspunktet passer dårlig.
# Parametrisk bootstrap

import warnings

np.random.seed(42)  # gir samme resultat hver gang cellen kjøres på nytt

n_total = len(failures) + len(right_censored)
T = np.concatenate([failures, right_censored])            # alder ved hendelse/siste observasjon
E = np.concatenate([np.ones(len(failures)), np.zeros(len(right_censored))])  # 1 = svikt, 0 = sensurert


def refit_gamma(T_new, E_new):
    """Tilpasser Gamma_2P på nytt til et simulert datasett. Returnerer None ved feil."""
    failures_new = T_new[E_new == 1]
    right_censored_new = T_new[E_new == 0]
    if len(failures_new) == 0:
        return None
    try:
        with warnings.catch_warnings():
            warnings.simplefilter("ignore")
            new_fit = Fit_Gamma_2P(
                failures=failures_new,
                right_censored=right_censored_new if len(right_censored_new) > 0 else None,
                show_probability_plot=False,
                print_results=False
            )
        return new_fit.alpha, new_fit.beta
    except Exception:
        return None


N = 1000  # antall simuleringer. Øk til 3000-5000 for et mer stabilt resultat, men regn med lengre kjøretid

p_boot, n_failed_fits, n_zero_failures = [], 0, 0

for i in range(N):
    # 1. Simuler et nytt, tenkt datasett fra den tilpassede modellen
    T_sim = gamma.rvs(a=alpha_hat, scale=theta_hat, size=n_total)
    # 2. Påfør samme sensureringsgrenser som i det ekte datasettet
    T_new = np.minimum(T_sim, T)
    E_new = (T_sim <= T).astype(int)

    if E_new.sum() == 0:
        n_zero_failures += 1
        continue

    # 3. Tilpass modellen på nytt til det simulerte datasettet
    result = refit_gamma(T_new, E_new)
    if result is None:
        n_failed_fits += 1
        continue

    theta_i, alpha_i = result
    if alpha_i <= 0 or theta_i <= 0:
        continue

    p = betinget_sannsynlighet(alpha_i, theta_i, a_alder, b_alder)
    if np.isfinite(p):
        p_boot.append(p)

p_boot = np.array(p_boot)
lower_boot, upper_boot = np.percentile(p_boot, [2.5, 97.5])

print(f"Bootstrap           95 % KI = ({lower_boot:.1%}, {upper_boot:.1%})  "
      f"[{len(p_boot)}/{N} vellykkede simuleringer]")

if n_failed_fits + n_zero_failures > N * 0.1:
    print("\nMerk: over 10 % av simuleringene ga ikke et gyldig resultat. "
          "Dette skjer typisk når det er få observerte svikt i datagrunnlaget, "
          "og er et tegn på at usikkerheten i estimatet er betydelig.")
WARNING: MLE estimates failed for Gamma_2P. The least squares estimates have been returned. These results may not be as accurate as MLE. Optimizers tried: TNC, L-BFGS-B, nelder-mead, powell
Bootstrap 95 % KI = (12.8%, 55.6%) [1000/1000 vellykkede simuleringer]
Hvordan tolke resultatet: Sammenlign gjerne bootstrap-intervallet med de to intervallene fra forrige del. Er de rimelig samstemte, kan man ha god tillit til resultatet. Er bootstrap-intervallet vesentlig bredere enn de andre, betyr det at normalitetsantakelsen i de raskere metodene ikke holder godt for dette datasettet – da bør bootstrap-intervallet foretrekkes, siden det ikke bygger på den antakelsen.
Source
# Lagre resultatene fra gamma-tilpasning til Excel
if 0:
    with pd.ExcelWriter("resultater.xlsx", engine="openpyxl") as writer:
        km.results.to_excel(writer, sheet_name="KaplanMeier", index = False)
        fit.results.to_excel(writer, sheet_name="Gamma_2P", index=False)
Forventet restlevetid
For investeringsanalysen er rekken av de årlige sviktsannsynlighetene det mest nyttige verktøyet. Men i forhold til kommunikasjon og overordnet forståelse, spesielt ved vurdering av mange ulike anlegg eller komponenter kan forventet restlevetid være et nyttig verktøy. Den betingede sviktsannsynligheten for et interval ble gitt tidligere som
Vi kan nå betrakte den betingede sviktsannsynlighetstettheten, gitt at objektet har overlevd fram til alder , gitt som:
der:
er komponentens levealder (stokastisk variabel)
er overlevelsesfunksjonen (sannsynligheten for at komponenten ikke har sviktet innen alder )
er komponentens nåværende alder
Forventet restlevetid (eng. mean residual life)
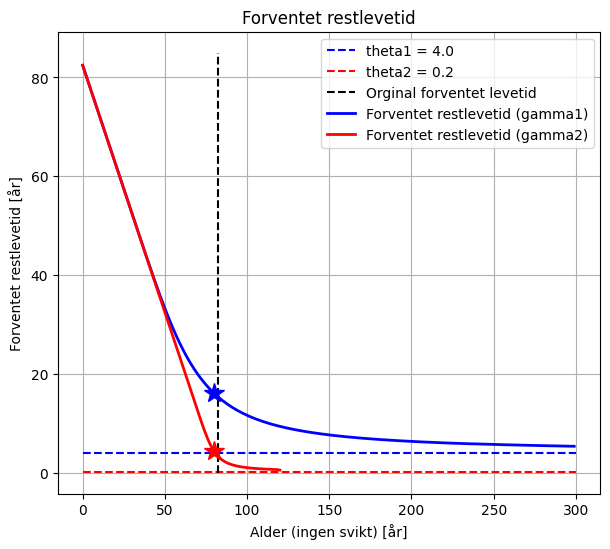
Nedenfor sammenliknes forventet restlevetid for to gamma-fordelinger med samme opprinnelige forventet levetid, men forskjellig usikkerhet. Merk at forventet restlevetid grenser mot når alder overstiger forventet levetid.
Source
from scipy.integrate import quad

def integrand(y,alpha,theta,x):
     return gamma.pdf(x+y,a=alpha,loc=0,scale =theta)*y

def forventet_restlevetid(alpha, theta,x):
    (rr,err)=quad(integrand,0,np.inf,(alpha,theta,x))
    rul=rr/(1-gamma.cdf(x,a=alpha,loc=0,scale = theta))
    return rul


mu = fit.alpha*fit.beta

theta1 = 4 #fit.alpha
alpha1 = mu/theta1 #fit.beta

x=np.arange(300)

theta2=0.2
alpha2=mu/theta2
mu2 = mu# fit.alpha*fit.beta

fig, ax = plt.subplots(figsize=(7,3))
ax.plot(x,gamma.pdf(x,a=alpha1,loc=0,scale = theta1),'b',label=f'gamma1 (alpha1={alpha1:.1f},theta1={theta1:.1f})')
ax.plot(x,gamma.pdf(x,a=alpha2,loc=0,scale = theta2),'r',label=f'gamma2 (alpha2={alpha2:.1f},theta2={theta2:.1f})')
plt.legend();plt.xlabel('Tid (år)');plt.ylabel('f(t)');plt.grid();
plt.show()

y=[]
y2 = []
for xx in x:
    y.append(forventet_restlevetid(alpha1, theta1,xx))
    y2.append(forventet_restlevetid(alpha2, theta2,xx))

y=np.array(y)
y2=np.array(y2)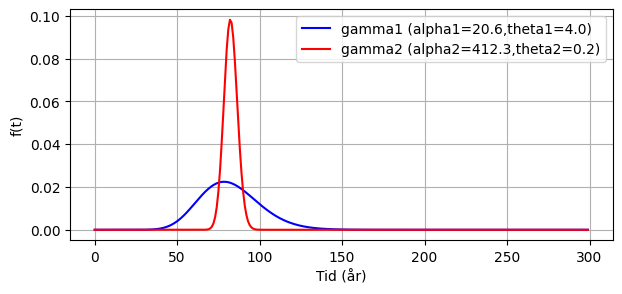
Anta at gamma1 og gamma2 representerer to komponenter med lik kritikalitet, for eksempel, to forskjellige typer turbiner (turbin1 og turbin2). Begge har forventet total levetid på ca. 80 år fra idriftssettelse, men sviktskurven til turbin1 er bredere. Anta så at begge nærmer seg 80 år og at en prioritering av turbin1 og turbin2 må bestemmes med tanke på fornyelse.
Nedenfor er forventet restlevetid plottet mot alder uten svikt. Ved alder 80 år er forventet restlevetid for turbin1 16 år og turbin2 4 år grunnet forskjelllen i usikkerhet i den opprinnelige fordelingen.
Source
fig, ax = plt.subplots(figsize=(7,6))

ax.plot([0,300],[theta1,theta1],'--b',label=f'theta1 = {theta1:.1f}')
ax.plot([0,300],[theta2,theta2],'--r',label=f'theta2 = {theta2:.1f}')
ax.plot([mu,mu],[0,85],'--k',label='Orginal forventet levetid')

ax.plot(x,y,'-', color='b', lw=2,label="Forventet restlevetid (gamma1)")
ax.plot(x[80],y[80],'*', color='b', markersize=15)
ax.plot(x,y2,'-', color='r', lw=2,label="Forventet restlevetid (gamma2)")
ax.plot(x[80],y2[80],'*', color='r', markersize=15)

#print(f'{y[80]}')
#print(f'{y2[80]}')

ax.legend();ax.grid()
plt.xlabel("Alder (ingen svikt) [år]")
plt.ylabel("Forventet restlevetid [år]")
plt.title("Forventet restlevetid")
plt.show()